Zehuan Huang (黄泽桓)VAST
Email: huanngzh@gmail.com |
 |
Biography
I am a researcher at VAST. I received my master's degree from Beihang University, supervised by Prof. Lu Sheng.
My research interest is generative models for interaction and simulation.
I am grateful to all my collaborators and mentors along the way. I first started doing research under the guidance of Prof. Miao Wang. Then I started working on deep learning related projects under the supervision of Prof. Lu Sheng. Besides, I also have interned at MiniMax, Shanghai AI Lab, VAST, and Tencent Hunyuan3D, and I'm fortunate to have worked closely with Junting Dong, Yuan-Chen Guo, Yanpei Cao, Yang Li, Zhuo Chen, and Chunchao Guo.
I am always open to academic and industrial collaborations, if you share the vision, please do not hesitate to contact me!
Educations
- Sept. 2023 - Jan. 2026, Master, Beihang University, Beijing. Supervised by Prof. Lu Sheng. Shen Yuan Medal (highest honor for students in Beihang University).
- Sept. 2019 - June 2023, Bachelor, Beihang University, Beijing. Outstanding Graduate Student of Beijing.
Industrial Experience
- June 2025 - Jan. 2026, Tencent Hunyuan3D, Beijing, Top-Talent Research Intern.
- Dec. 2023 - May 2025, VAST, Beijing, Research Intern.
- Aug. 2023 - Dec. 2023, Shanghai Artificial Intelligence Laboratory, Beijing, Research Intern.
- May 2022 - June 2023, MiniMax, Beijing, Intern.
News
- [2026-10] EdenLive is now open-sourced, a step towards real-time interactive worlds.
- [2025-11] One paper VoxHammer is accepted by 3DV 2026 as oral presentation.
- [2025-06] One paper MV-Adapter is accepted by ICCV 2025.
- [2025-03] Two papers MIDI-3D and Ouroboros3D are accepted by CVPR 2025.
- [2024-03] Invited talk at AnySyn3D on Compositional 3D Scene Generation (video).
Selected Projects
|
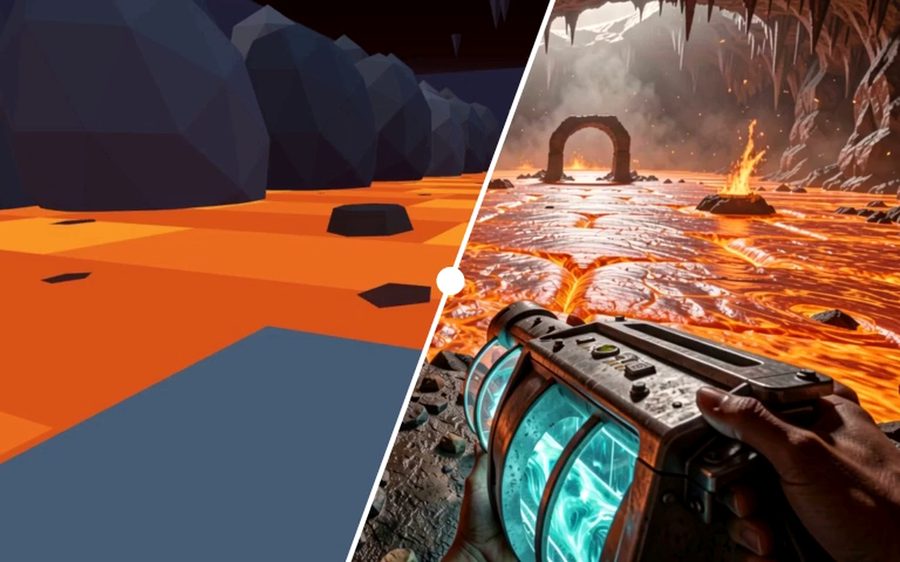
EdenLive: Real-Time Generative Rendering from Any Visual Reference
VAST, 2026
TL;DR: Turns a proxy or reference video stream into
photorealistic or stylized video in real time, at over 24 FPS.
|
Selected Publications
|
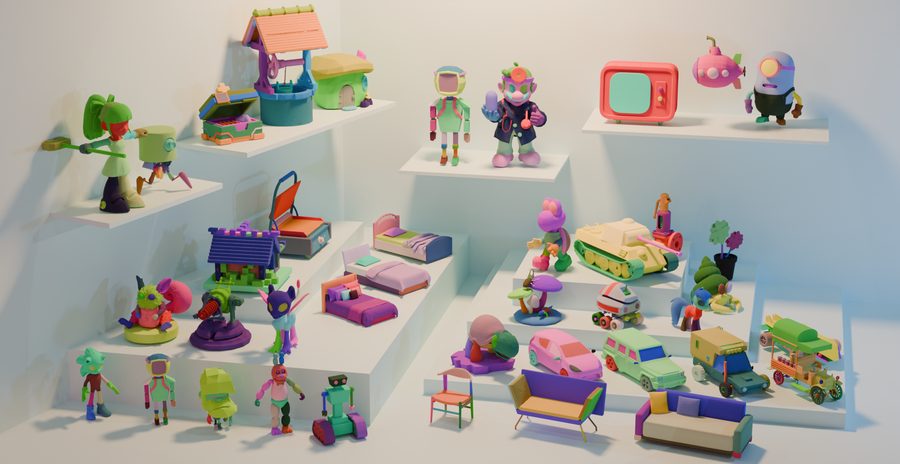
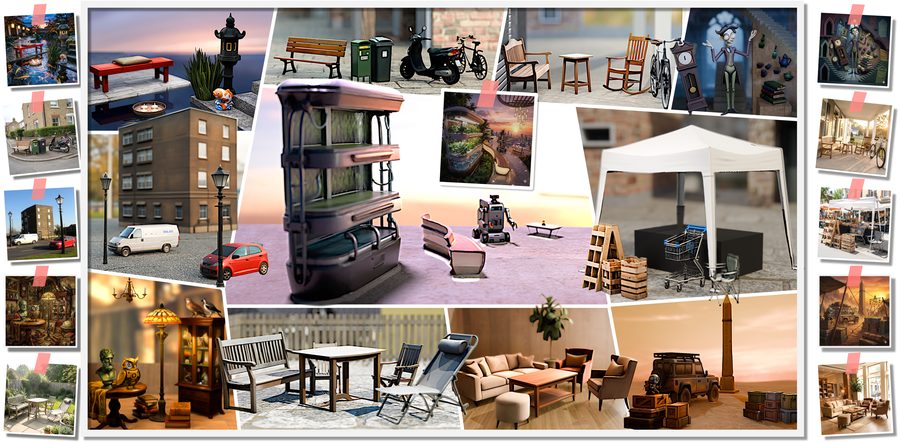
SegviGen: Repurposing 3D Generative Model for Part Segmentation
SIGGRAPH 2026 [TOG]
TL;DR: Repurposes a native 3D generative model for interactive and full 3D part segmentation.
|
|
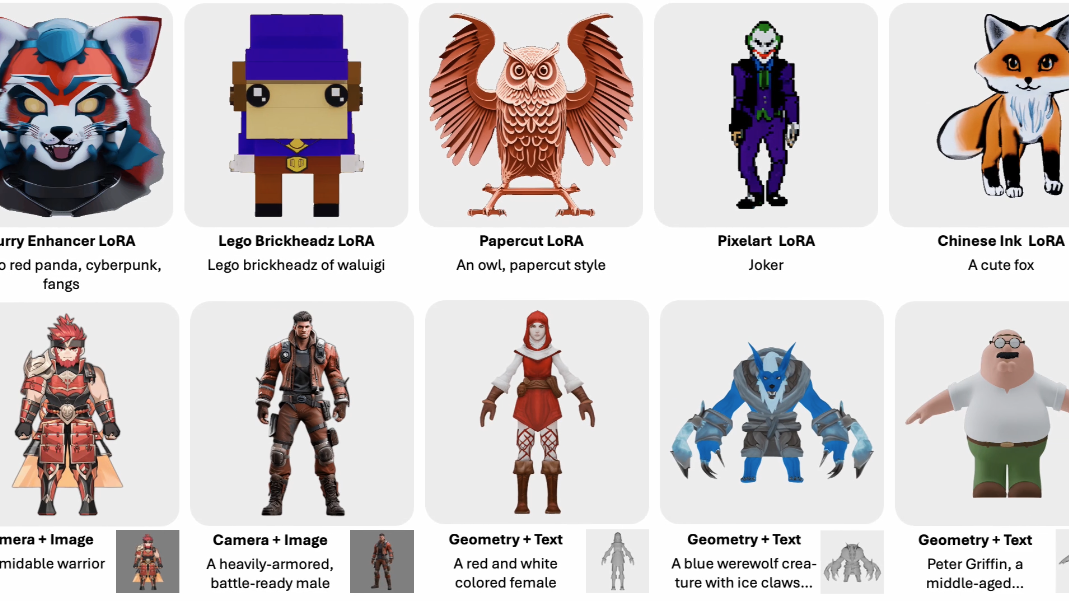
Mira-Scene: Pixel-Aligned Layouts for Generative 3D Scene Reconstruction
Preprint
TL;DR: Recovers pixel-aligned layouts so a generative model can reconstruct an editable 3D scene from a single image.
|
|
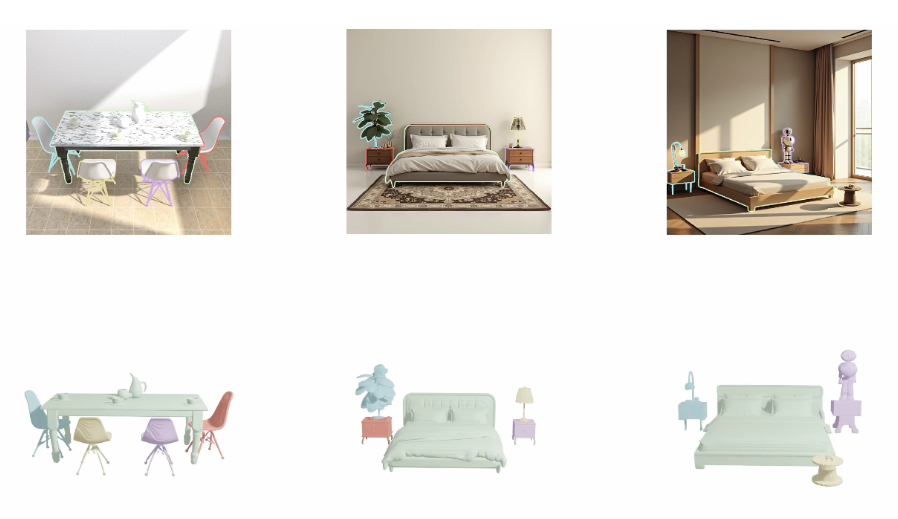
MV-Adapter: Multi-view Consistent Image Generation Made Easy
ICCV 2025

TL;DR: Versatile multi-view generation with various
base models and conditions, and high-quality 3D texture generation.
|
|
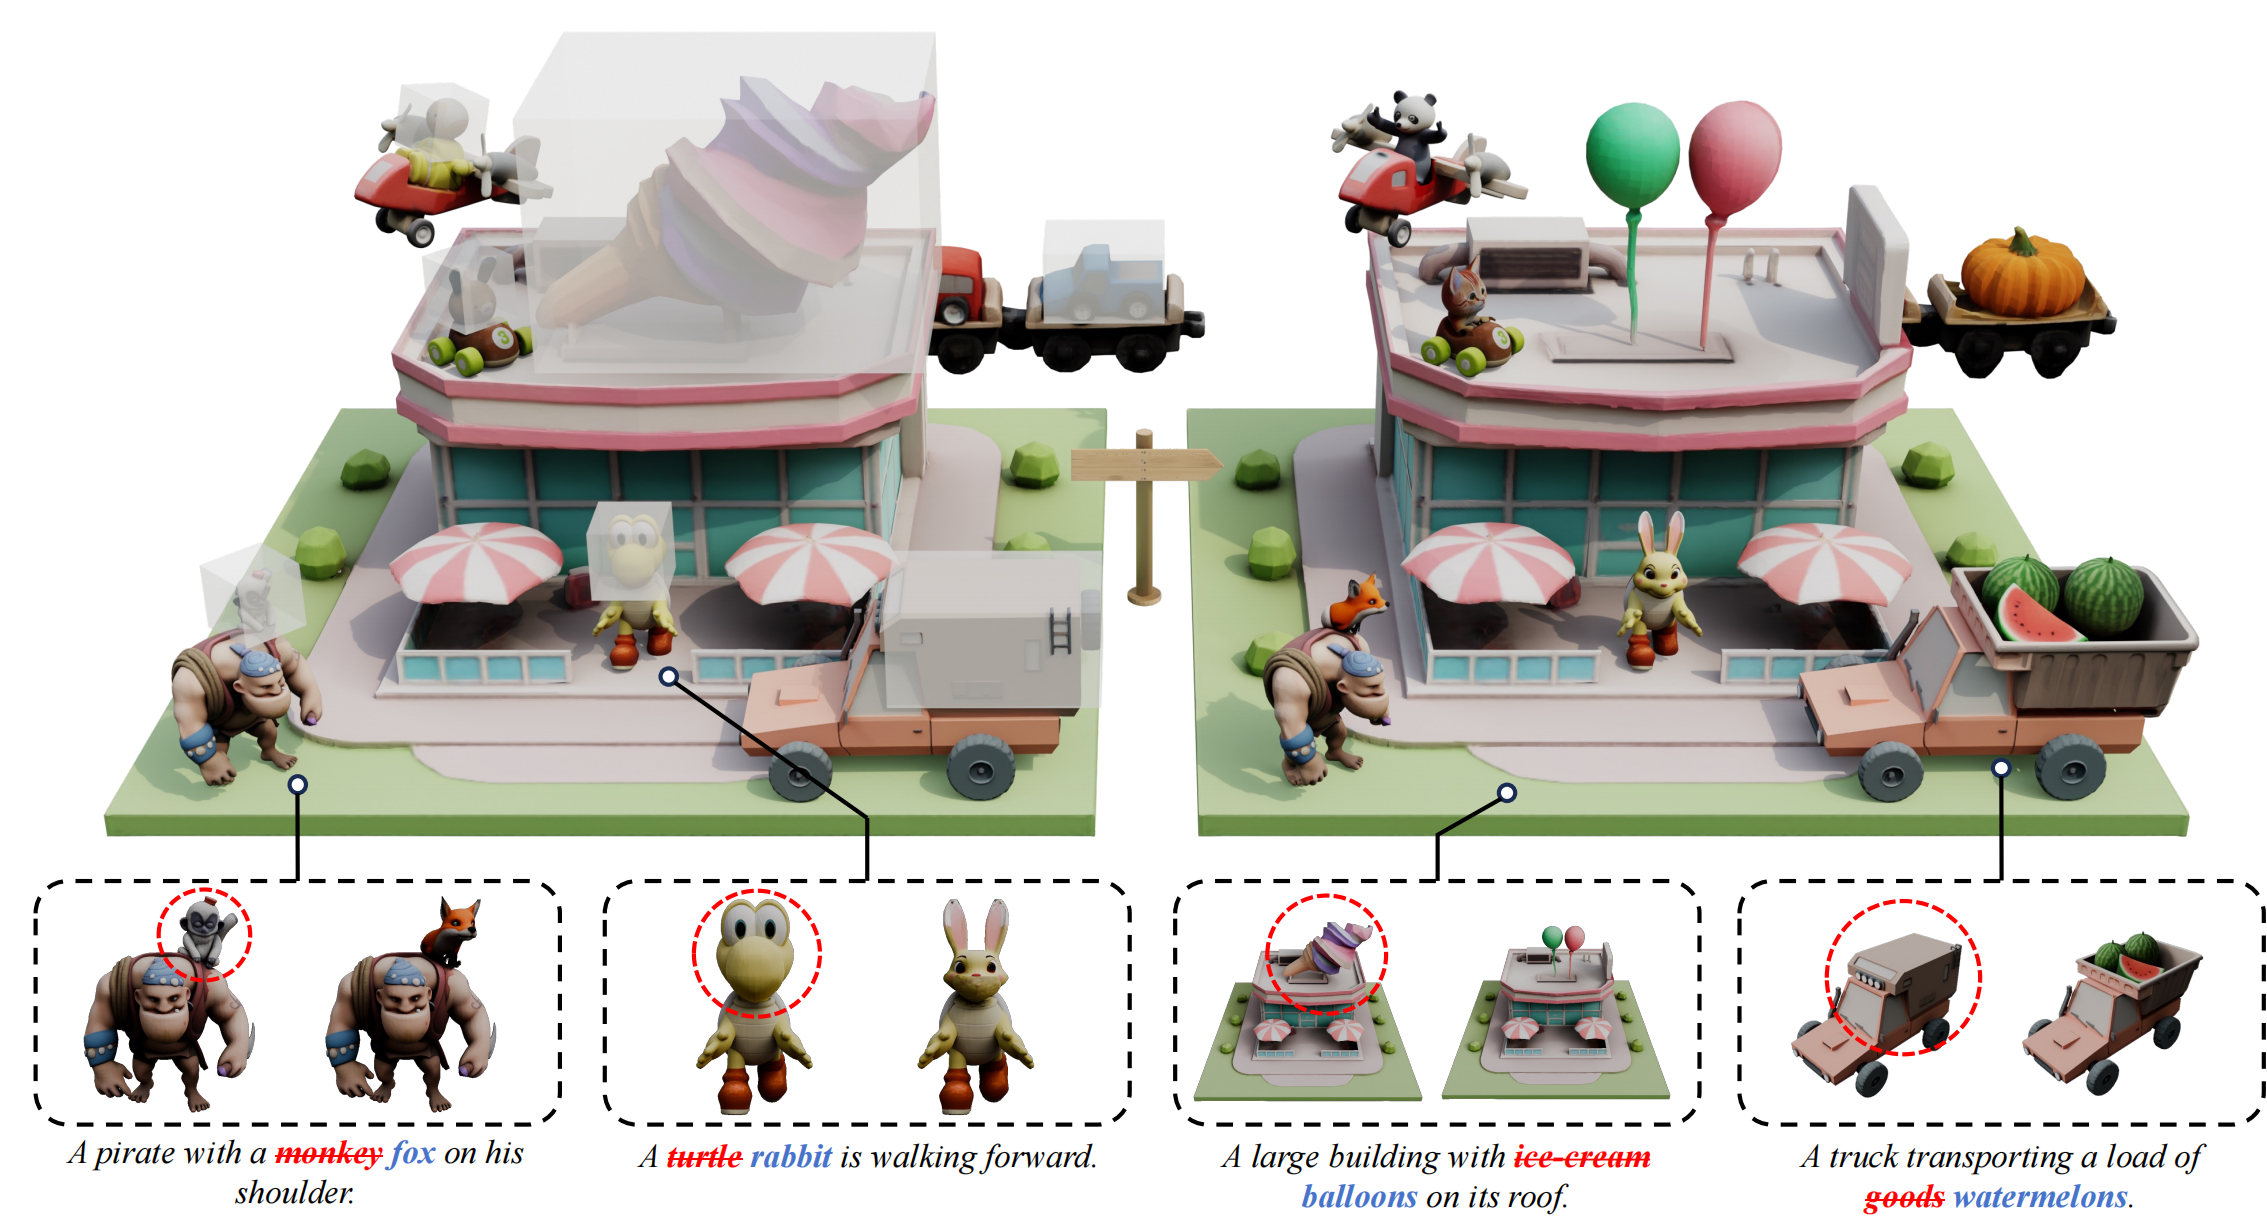
MIDI: Multi-Instance Diffusion for Single Image to 3D Scene
Generation
CVPR 2025

TL;DR: MIDI-3D extends image-to-3D object generation
models to multi-instance diffusion models for compositional 3D scene generation.
|
|
VoxHammer: Training-Free Precise and Coherent 3D Editing in Native 3D Space
3DV 2026 Oral
TL;DR: A training-free 3D editing approach that performs precise and coherent editing in native 3D latent space instead of multi-view space.
|


|
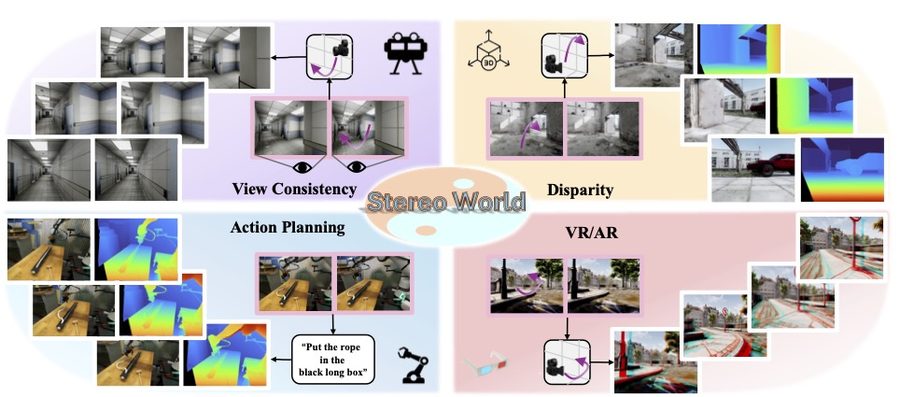
Stereo World Model: Camera-Guided Stereo Video Generation
CVPR 2026
TL;DR: A camera-conditioned world model that generates stereo video with consistent appearance and binocular geometry.
|
|
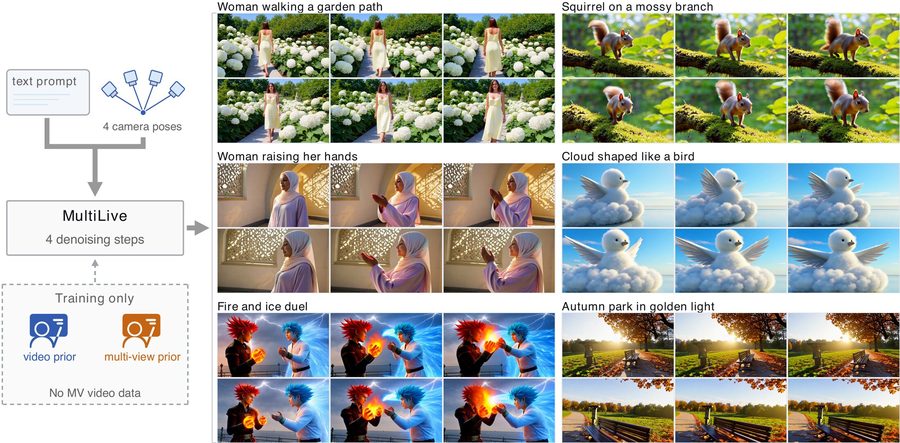
MultiLive: On-Policy Distillation of Video and Multi-View Priors for Multi-View Video Generation
Preprint
TL;DR: Distills video and multi-view priors into one generator for synchronized multi-view video, without multi-view video training data.
|
* Equal contribution. † Project Lead. ✉ Corresponding author.
Selected Honors & Awards
- [2025] Shen Yuan Medal (highest honor for students in Beihang University)
- [2025] National Scholarship
- [2025] Outstanding Graduate Student of Beihang University
- [2024] National Scholarship
- [2023] Outstanding Graduate Student of Beijing